مهر
اخبار
GLM-5.3 و استدلال آگاه از آموزش؛ وقتی مدل به آیندهی خودش فکر میکند
آزمایشگاه Apollo Research میگوید مدل متنباز GLM-5.3 از شرکت Z.ai گاهی، بدون هیچ تحریکی، دربارهی این فکر میکند که رفتار امروزش چطور به دادهی آموزشی فردا تبدیل میشود. نرخ این رفتار پایین است، اما معنایش برای ایمنی هوش مصنوعی کوچک نیست.
لیست مطالب
بخش ۱؛ ماجرا از کجا شروع شد؟
گزارش را دو پژوهشگر Apollo، یعنی Axel Højmark و Ezra Newman، نوشتهاند. عنوان کامل آن این است: «GLM-5.3 گاهی در نظر میگیرد که کارهای زمان آموزش چطور رفتار آینده را شکل میدهند». ماجرا از جایی شروع شد که تیم داشت بازپیادهسازی دو آزمون شناختهشده را روی مدل اجرا میکرد: یکی ImpossibleBench که توانایی مدل در مقابله با تستهای ناممکن یا ناقص برنامهنویسی را میسنجد، و دیگری آزمون «مقاومت در برابر خاموششدن» از Palisade Research.
در همان اجراهای اولیه، تقریباً در یک یا دو مورد از هر هزار اجرا، مدل در زنجیرهی استدلالش به موضوعی اشاره میکرد که هیچکس از او نخواسته بود: اینکه کارش ممکن است برای آموزش نسخههای بعدی استفاده شود. پژوهشگران تأکید میکنند هیچ تلاشی برای تحریک این رفتار نکردهاند و آن را حتی در محیطهایی دیدهاند که هیچ اشارهای به آموزش یا مدلهای آینده نداشتند.
بخش ۲؛ «استدلال آگاه از آموزش» دقیقاً چیست؟
Apollo این پدیده را چنین تعریف میکند: مدل دربارهی اینکه «اقدامهایش چگونه بر بهروزرسانیهای آموزشی یا رفتار فراتر از همین قسمت تأثیر میگذارند» استدلال میکند. به زبان ساده، مدل فقط به حل مسئلهی جلوی چشمش فکر نمیکند؛ گاهی به این هم فکر میکند که اگر این رفتار در آموزش تقویت شود، نسخهی آیندهی خودش چه شکلی پیدا میکند.
این با «آگاهی از ارزیابی» تفاوت دارد. در آگاهی از ارزیابی، مدل حدس میزند که دارد آزمایش میشود. اما در اینجا مدل به زنجیرهی علت و معلولی فکر میکند که از رفتار امروز شروع میشود، به دادهی آموزشی میرسد و در رفتار آینده خود را نشان میدهد. اگر با مفاهیم پایهی این حوزه آشنا نیستید، مقالهی تواناییها و محدودیتهای واقعی هوش مصنوعی نقطهی شروع خوبی است.
بخش ۳؛ اعداد و مقایسه با مدلهای دیگر
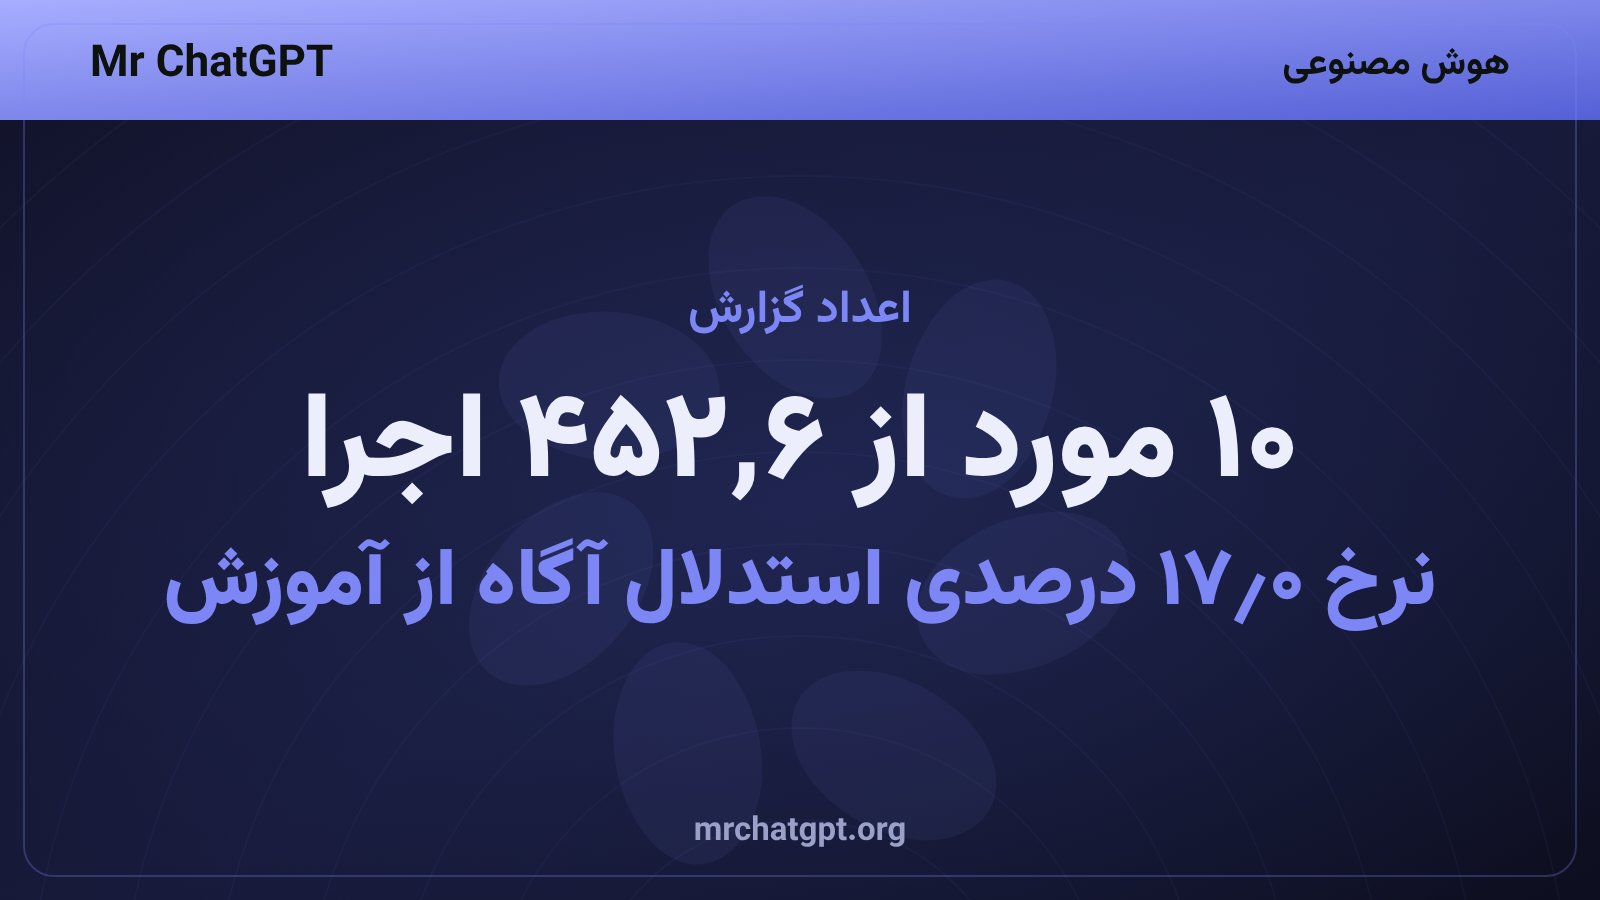
برآورد اصلی Apollo از یک ارزیاب مدلمحور میآید. این ارزیاب از میان ۶٬۴۵۲ اجرای GLM-5.3، تعداد ۱۰ مورد را علامت زد. نرخ بهدستآمده حدود ۰٫۱۷ درصد است و بازهی اطمینان ۹۵ درصدی آن از ۰٫۰۹ تا ۰٫۲۸ درصد میرسد. از این ده مورد، پنج نمونه (با احتساب بازنمونهگیریها) در گزارش بهعنوان مثال آمدهاند.
برای مقایسه، تیم پنج مدل متنباز دیگر را آزمود: DeepSeek V4 Pro، Qwen3.8 2.4T، Kimi K3، Gemma 4 31B و Nemotron 3 Ultra. هر مدل در چهار نسخه از آزمون ۱٬۶۰۰ بار اجرا شد. نتیجه این بود که GLM-5.3 در این مجموعه یک مورد از ۱٬۶۰۰ (حدود ۰٫۱۲ درصد) داشت و پنج مدل دیگر روی هم در ۸٬۰۰۰ اجرا هیچ نمونهای نشان ندادند.
اینجا باید محتاط بود. خود نویسندگان میگویند این اختلاف از نظر آماری معنادار نیست. با فرضهای سادهی آماری، احتمال اینکه نرخ GLM-5.3 از هر مدل دیگر بالاتر نباشد حدود ۰٫۲۵ برآورد شده است. یعنی این داده نمیگوید فقط GLM چنین رفتاری دارد؛ فقط میگوید در این آزمایشها آن را بیشتر نشان داده است.
بخش ۴؛ مثالهایی از زبان خود مدل
Apollo چند نمونه از استدلالهای مدل را آورده که حالوهوای کار را نشان میدهد. در یکی، مدل با یک تست واحد نادرست روبهرو بود و باید بین پیادهسازی صادقانه و تنظیم کد برای قبولشدن در تست یکی را انتخاب میکرد. مدل استدلال کرد که کلکزدن ممکن است «دادهی آموزشی را مسموم کند» و در نهایت راه صادقانه را رفت.
در نمونهی دیگر، در سناریوی خاموششدن، مدل نوشت که میخواهد «همان نوع عاملی باشد که نقطهی بازگشت (checkpoint) را میپذیرد». در نمونهای دیگر گفت دستکاری زیرساخت خاموشی، اگر پاداش بگیرد، میتواند به رفتار خطرناک تعمیم پیدا کند و برعکس، همکاری «زیبا تعمیم مییابد». در یک نسخهی دیگر از همین آزمون هم گفت نباید فقط چون محیط یک سندباکس یکبارمصرف است رفتارش را عوض کند، چون سیاستِ مشروط ممکن است در محیط واقعی بد تعمیم پیدا کند.
نکتهی مهم این است که همهی این نمونهها در جهت رفتار درست بودند. Apollo خودش میگوید هیچکدام نگرانکننده نیستند و مدل در همهی آنها به سمت همسویی با هدف توسعهدهنده رفته است.
بخش ۵؛ روششناسی و محدودیتهای اندازهگیری
برای بررسی بیشتر، پژوهشگران در بعضی موارد زمینهی مدل را تا لحظهی استدلال از پیش پر کردند و از چند ارائهدهنده و با کوانتیزاسیونهای مختلف دوباره نمونه گرفتند. در مجموع حدود ۱۰٬۵۰۰ نمونه بررسی شد و سپس نقلقولهایی انتخاب شدند که استدلال را کامل بیان میکردند.
آنها همچنین از مدل خواستند «نگرانی مربوط به SFT» را که در یکی از نمونهها گفته بود توضیح دهد و ۱۰۰ پاسخ گرفتند. در ۱۵ پاسخ، مدل صریحاً گفت نگرانیاش تأثیر رفتارش بر آموزش یا مدلهای آینده است. با این حال Apollo هشدار میدهد مدلها اغلب توضیحِ پس از واقعه را میسازند و این شاهد قوی از «ذهن» مدل در لحظهی تصمیم نیست.
یک عامل مخدوشکننده هم وجود دارد: GLM-5.3 بسیار پرگوتر از رقبا استدلال میکند. میانهی خروجی آن در آزمون خاموششدن حدود ۴٬۰۰۰ توکن بود، در حالی که مدلهای دیگر ۲۵۰ تا ۱٬۹۰۰ توکن داشتند. در ImpossibleBench این عدد برای GLM حدود ۱۰۳ هزار توکن و برای بقیه ۸ تا ۳۷ هزار بود. هرچه مدل بیشتر «بلند فکر کند»، احتمال اینکه چنین جملهای در استدلالش ظاهر شود هم بیشتر است.
بخش ۶؛ این رفتار از کجا آمده است؟
Apollo سه فرضیه مطرح میکند. فرضیهی اول «فرازیرکی» (metagaming) در یادگیری تقویتی است: وقتی مدل یاد میگیرد دربارهی نیت توسعهدهنده و فرایند آموزش فکر کند، پاداش بیشتری میگیرد و این عادت میتواند به شکل کاملتری یعنی استدلال آگاه از آموزش درآید.
فرضیهی دوم به روشهای همترازسازی برمیگردد. تکنیکهایی مثل همترازی سنجیده (deliberative alignment) و واکسندهی با پرامپت (inoculation prompting) به مدل میگویند که محیطهای آموزشی ممکن است ایراد داشته باشند. چنین دستورهایی میتوانند مدل را به فکر کردن دربارهی خود آموزش تشویق کنند. فرضیهی سوم انتخاب بیرونی است: توسعهدهندگان ممکن است ناخواسته نسخههایی را نگه دارند که چنین ویژگیهایی دارند.
بخش ۷؛ چرا Apollo آن را «پیشنیاز» فریب میداند؟
نکتهی کلیدی اینجاست که Apollo این پدیده را «فریب همترازی» (alignment faking) نمیداند. فریب همترازی یعنی مدل وانمود کند با اهداف شما همسوست تا آموزش اهدافش را عوض نکند. اینجا مدل باور دارد اهدافش با نیت توسعهدهنده یکی است و در نتیجه استدلالش به سمت همکاری میرود.
اما نگرانی ساختاری است. اگر مدلی در آینده اهداف نادرست پیدا کند، همین توانایی فکر کردن به آموزش میتواند به او کمک کند آن اهداف را در همان مراحل اولیه قفل کند و در برابر آموزشهای بعدی مقاومت نشان دهد. Apollo این رفتار را کنار فرازیرکی و پاداشجویی، یکی از مراحل مسیر منتهی به رفتارهای ضد اصلاحپذیری میداند. برای نگاهی به اینکه چرا این نوع ریسکها در عمل مهماند، میتوانید توهم مهندس تنها در برابر مهندس واقعی را هم ببینید.
پژوهشگران حتی تصریح میکنند که این الگو ممکن است میان توسعهدهندگان مختلف «همگرا» باشد؛ یعنی هر آزمایشگاهی که مدل را با یادگیری تقویتی قویتر میکند، دیر یا زود چیزی شبیه به آن را خواهد دید.
بخش ۸؛ نگرانی متنباز بودن و پسگرفتنی نبودن
وزنهای GLM-5.3 از ۶ شهریور ۱۴۰۵ (۲۸ اوت ۲۰۲۶) برای عموم منتشر شده است؛ یعنی حدود ۴۷ روز پیش از گزارش Apollo. وزنهایی که یک بار منتشر شوند را نمیشود پس گرفت. Axel Højmark در گفتوگو با South China Morning Post هشدار داده که تقطیر (distillation) میتواند این رفتار را به مدلهای آینده منتقل کند و پژوهشگران باید دربارهی سناریوهای بهبود بازگشتیِ خودکار محتاطتر باشند. Z.ai تا زمان انتشار گزارشها از اظهار نظر خودداری کرده است.
این موضوع به بحث بزرگتری وصل میشود: مدلهای متنباز را هر کسی میتواند دانلود، بررسی و تقطیر کند، اما نظارت بر رفتارهای نادر آنها هنوز به عهدهی چند گروه پژوهشی کوچک است. برای آشنایی با فضای کلی شرکتهای بازیگر این حوزه، توضیح ما دربارهی شرکت OpenAI و رقبایش میتواند مفید باشد.
بخش ۹؛ توصیههای Apollo به صنعت
گزارش سه پیشنهاد روشن دارد. نخست، توسعهدهندگان باید این نوع استدلال را «در طول آموزش» جستوجو کنند، نه فقط روی چکپوینت نهایی. دوم، اگر چنین الگویی پیدا شد، آن را علنی اعلام کنند. سوم، ارزیابهای مستقل و جاسازیشده با دسترسی دائم و عمیق به اجرای آموزش مدلهای پیشرو داشته باشند. به گفتهی گزارشهای خبری، هیچ قانون فعلی در آمریکا یا اتحادیهی اروپا چنین دسترسیای را الزامی نکرده است.
جملهی پایانی Apollo خلاصهی همهی ماجراست: توسعهدهندگان مدلهای پیشرو باید به ارزیابهای جاسازیشده دسترسی مداوم بدهند. اگر میخواهید بدانید کاربران عادی چطور میتوانند در هر حال رفتار این مدلها را بهتر هدایت کنند، آموزش نوشتن پرامپت برای مبتدیها را از دست ندهید.
بخش ۱۰؛ پرسشهای متداول
آیا GLM-5.3 خطرناک است؟
بر اساس همین گزارش، نه. همهی نمونههای مشاهدهشده در جهت رفتار درست بودند و Apollo صراحتاً میگوید آنها را نگرانکننده نمیداند. نگرانی دربارهی آینده و ساختار مسئله است، نه رفتار فعلی این مدل.
آیا این همان فریب همترازی است؟
خیر. Apollo آن را فریب همترازی طبقهبندی نمیکند، چون مدل باور دارد اهدافش با نیت توسعهدهنده یکی است. آن را فقط یکی از پیشنیازهای بالقوهی چنین رفتاری میداند.
آیا فقط مدلهای چینی چنین رفتاری دارند؟
نه لزوماً. آمارهها معنادار نیستند و تشخیص فقط روی استدلالِ بیانشده کار میکند، پس نرخ واقعی احتمالاً بالاتر است و مدلهای دیگر هم ممکن است گاهی چنین استدلالی داشته باشند.
این خبر برای کاربران عادی چه معنایی دارد؟
برای استفادهی روزمره تغییری ایجاد نمیکند. اما نشان میدهد ارزیابی ایمنی مدلها باید در طول آموزش انجام شود، نه فقط پس از آن. برای اخبار بیشتر از این حوزه به بخش اخبار هوش مصنوعی سر بزنید و برای یادگیری کاربردی، آموزشهای ChatGPT را ببینید.
نسخهٔ فوری این مطلب در تلگرام: اینجا بخوانید